خبر کامل
کپچاهای قدیمی اینترنت؛ ابزاری برای نجات ۴۴۰ میلیون کلمه تاریخی
نقش پنهان کپچاهای قدیمی در نجات تاریخ
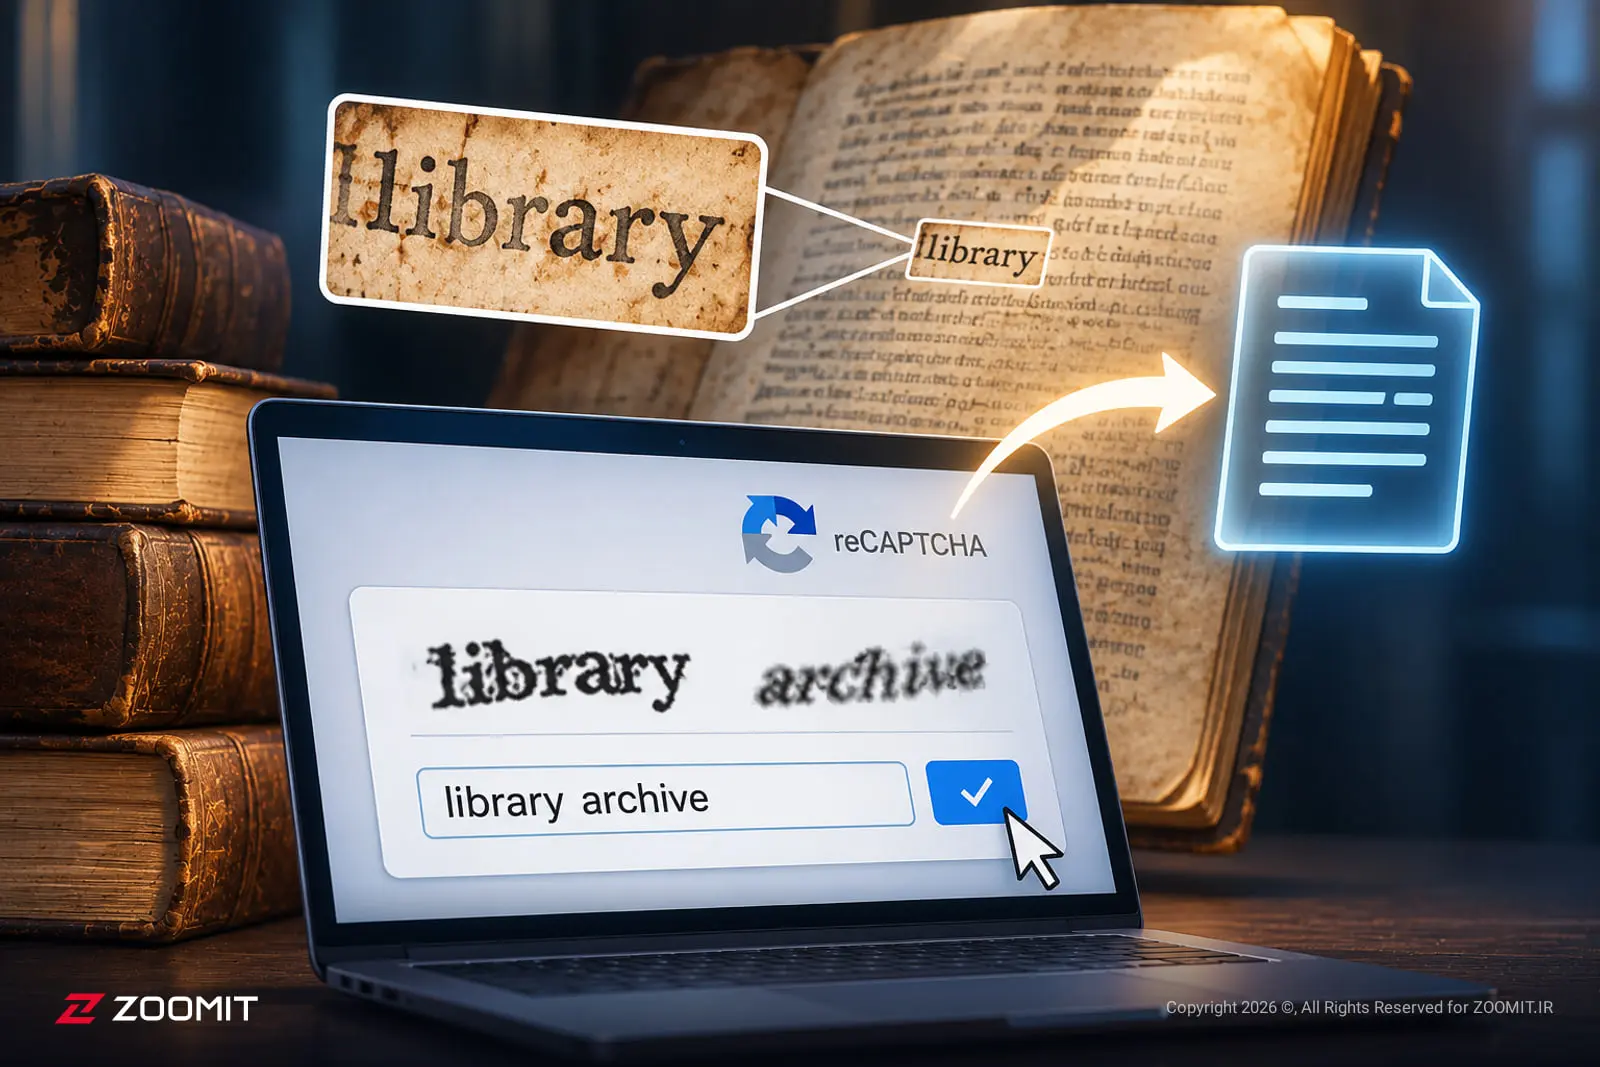
سالها پیش، زمانی که کاربران برای عبور از سدهای امنیتی وب، کلمات ناخوانا را تایپ میکردند، در واقع در حال انجام یک ماموریت بزرگ بودند. کپچاهای قدیمی اینترنت تنها ابزاری برای تشخیص ربات نبودند، بلکه موتور محرک پروژهای عظیم برای دیجیتالیسازی اسناد تاریخی بودند.
چگونه کلمات ناخوانا به متن دیجیتال تبدیل شدند؟
در فرآیند اسکن کتابهای قدیمی، تکنولوژی تشخیص متن (OCR) اغلب در برابر کاغذهای فرسوده و لکههای جوهر شکست میخورد. در این میان، سیستم reCAPTCHA با استفاده از هوش جمعی کاربران، این شکاف را پر کرد.
ساختار این فرآیند به شرح زیر بود:
- نمایش دو کلمه به کاربر: یکی برای تایید هویت و دیگری متعلق به یک سند اسکنشده.
- تایپ کلمه توسط انسان برای حل مشکل نرمافزاری.
- مقایسه پاسخهای کاربران مختلف برای تضمین دقت بالا.
دستاورد خیرهکننده در بازخوانی اسناد
پژوهشی که در سال ۲۰۰۸ در نشریه Science منتشر شد، نشان داد که این رویکرد توانسته است بیش از ۴۴۰ میلیون کلمه را از حالت ناخوانا به متن قابل جستوجو تبدیل کند. دقت این سامانه در شناسایی کلمات به بیش از ۹۹ درصد رسید.
| شاخص عملکرد | مقدار/نتیجه |
|---|---|
| تعداد کلمات نجات یافته | +۴۴۰ میلیون کلمه |
| دقت تشخیص کلمات | بیش از ۹۹٪ |
| سال تصاحب توسط گوگل | ۲۰۰۹ |
تغییر پارادایم با ظهور هوش مصنوعی
با پیشرفت خیرهکننده هوش مصنوعی، نیاز به تایپ کلمات ناخوانا از بین رفت. گوگل امروزه از روشهای پیشرفتهتری مانند تحلیل رفتار کاربر و تشخیص تصاویر برای احراز هویت استفاده میکند.
«میلیونها نفر بدون آنکه بدانند، بخشی از نوشتههای فراموششده تاریخ را دوباره زنده کردند.»
نتیجهگیری
در نهایت، کپچاهای قدیمی اینترنت نمادی از همکاری بیدریغ انسانها با فناوری بودند. این تجربه نشان داد که چگونه تواناییهای انسانی میتواند مکمل نقصهای ماشین در مسیر حفظ میراث فرهنگی باشد.
درباره هوشمصنوعی دستاول:
تمامی اخبار دستاول توسط دستیار هوش مصنوعی «هوشنگ» پردازش، صحتسنجی، خلاصه و بازنویسی شده است. هوشنگ هر روز با دادههای جدید آموزش داده میشود و با نظارت دقیق انسانی و سردبیری دستاول در حال بهتر شدن است.
شما میتوانید از چتبات و سایر ابزارهای هوشنگ به صورت رایگان استفاده کنید.
زمان انتشار:
۱۲:۴۰ - ۱۴۰۵/۰۸/۱۶