خبر کامل
هوش مصنوعی برای زبانهای غیرانگلیسی تا ۱۸۰ برابر انرژی بیشتری مصرف میکند
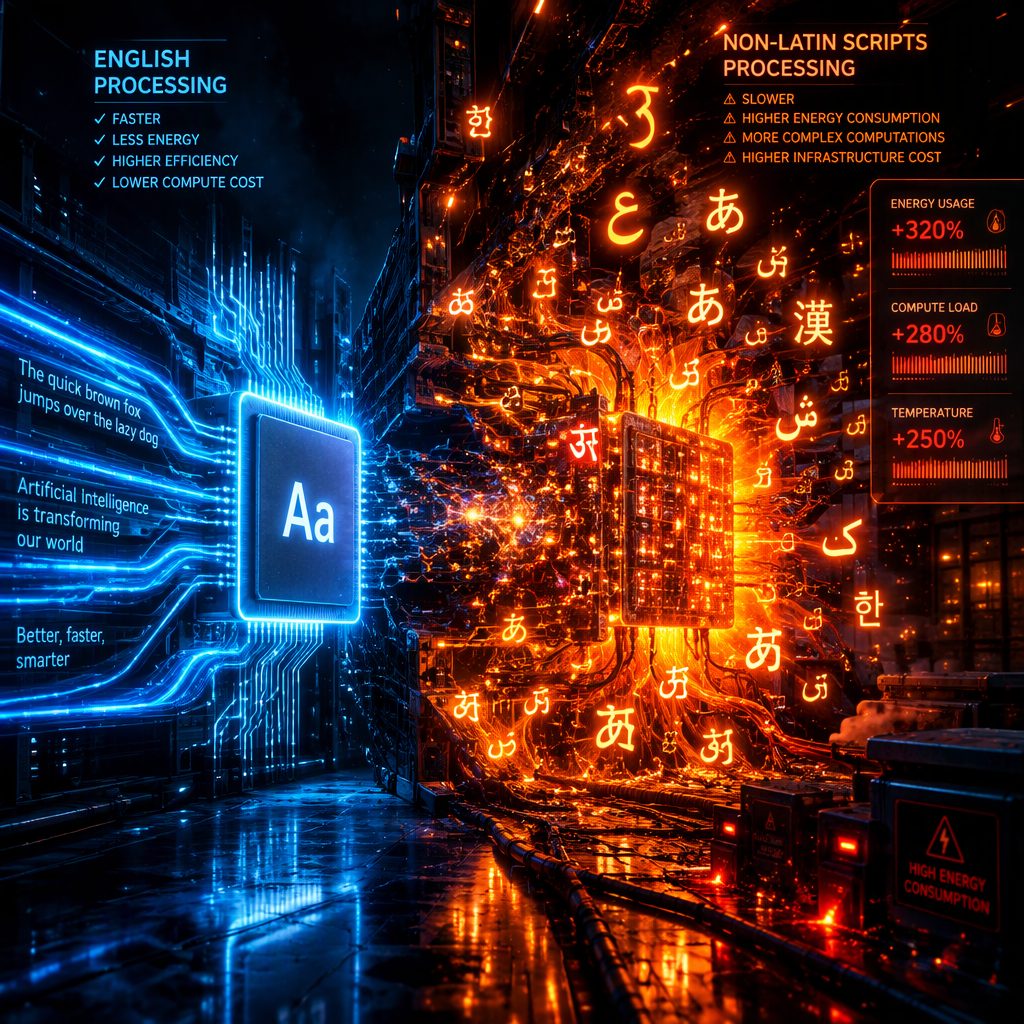
تحقیقات جدید نشان میدهد که استفاده از هوش مصنوعی برای پردازش زبانهای غیرانگلیسی، علاوه بر افزایش چشمگیر مصرف انرژی، منجر به کاهش دقت پاسخها نیز میشود. این یافتهها میتواند پیامدهای گستردهای برای عدالت دیجیتال در سطح جهان داشته باشد.
شکاف انرژی در دنیای هوش مصنوعی
بر اساس پژوهشی که توسط مهندسان دانشگاه میشیگان انجام شده و در کنفرانس EMNLP ارائه گردیده، مدلهای هوش مصنوعی مولد برای تولید متن در زبانهای غیرانگلیسی، بین ۱.۴ تا ۱۸۰ برابر انرژی بیشتری نسبت به زبان انگلیسی مصرف میکنند. این اختلاف فاحش، بهویژه در زبانهایی که از الفبای لاتین استفاده نمیکنند، بسیار مشهود است.
در حالی که مصرف انرژی برای زبانهای اروپای غربی تنها حدود دو برابر انگلیسی است، زبانهایی مانند هندی و بنگالی به ترتیب ۷.۹ و ۱۵.۳ برابر بیشتر از یک درخواست معادل به زبان انگلیسی، انرژی مصرف میکنند.
چرا زبانهای غیرانگلیسی هزینهبر هستند؟
ریشه اصلی این مسئله در نحوه پردازش دادهها توسط مدلها نهفته است. هوش مصنوعی متن را به واحدهای کوچکی به نام «توکن» تقسیم میکند. در زبانهایی که ساختار نوشتاری پیچیدهای دارند، مدل ناچار است متن را به تعداد بسیار بیشتری توکن تقسیم کند.
| نوع زبان | میزان مصرف انرژی (نسبت به انگلیسی) | وضعیت دقت |
|---|---|---|
| انگلیسی | ۱ (مرجع) | بسیار بالا |
| اروپای غربی | تا ۲ برابر | بالا |
| هندی | ۷.۹ برابر | متوسط/پایین |
| بنگالی | ۱۵.۳ برابر | پایین |
تولید توکنهای بیشتر، علاوه بر اشغال حافظه بیشتر در پردازندهها، باعث میشود مدلها نتوانند اطلاعات را در دستههای بزرگ پردازش کنند. این فرآیند منجر به «جریمه دوطرفه» میشود: مصرف انرژی بالاتر و دقت پایینتر در خروجی نهایی.
پیامدهای اجتماعی و اقتصادی
«زبانهایی که انرژی بیشتری مصرف میکنند، معمولاً در خروجی مدل نیز دقت پایینتری دارند. این موضوع باعث محرومیت بسیاری از افراد از دسترسی عادلانه به فناوری میشود.»
این پژوهش که بر روی مدلهای متنباز مانند Llama 3.1، Gemma 3 و Qwen 3 انجام شده، هشدار میدهد که حدود ۵.۲ میلیارد نفر در جهان با چالشهای مالی و کیفی در استفاده از این فناوریها روبرو هستند. از آنجا که شرکتها هزینه خدمات را بر اساس تعداد توکنها محاسبه میکنند، کاربران غیرانگلیسیزبان همواره هزینهی بیشتری پرداخت میکنند.
نتیجهگیری و راهکارها
برای کاهش این نابرابری، محققان پیشنهاد میکنند شرکتهای پیشرو در حوزه هوش مصنوعی، مدلهای خود را برای زبانهای متنوع بهینهسازی کنند. راهکارهایی نظیر ترجمه خودکار پرامپتها به انگلیسی پیش از پردازش یا استفاده از مدلهای اختصاصی برای هر زبان، میتواند گامی موثر در جهت عدالت در توزیع فناوری باشد.
درباره هوشمصنوعی دستاول:
تمامی اخبار دستاول توسط دستیار هوش مصنوعی «هوشنگ» پردازش، صحتسنجی، خلاصه و بازنویسی شده است. هوشنگ هر روز با دادههای جدید آموزش داده میشود و با نظارت دقیق انسانی و سردبیری دستاول در حال بهتر شدن است.
شما میتوانید از چتبات و سایر ابزارهای هوشنگ به صورت رایگان استفاده کنید.
زمان انتشار:
۰۵:۰۰ - ۱۴۰۵/۰۸/۲۴